
줄리아에서 HTTP 프로토콜을 통해 EARTHDATA 데이터 다운로드 받는 법
개요
EARTHDATA에서 데이터를 일일이 손으로 클릭해서 받고 정리하는 것은 쉽지 않은 일이다. 줄리아에서 HTTP 프로토콜을 통해 데이터를 받고, 필요한 영역을 추출해서 저장하는 방법을 소개한다.
코드
HTTP.jl
이 가이드에서는 니뇨 3.4 영역인 위도 5°S~5°N, 경도 170°W~120°W의 해수면온도와 해류 데이터를 받아보도록 하자. 먼저 EARTHDATA의 인증 토큰과 데이터를 지정한다.
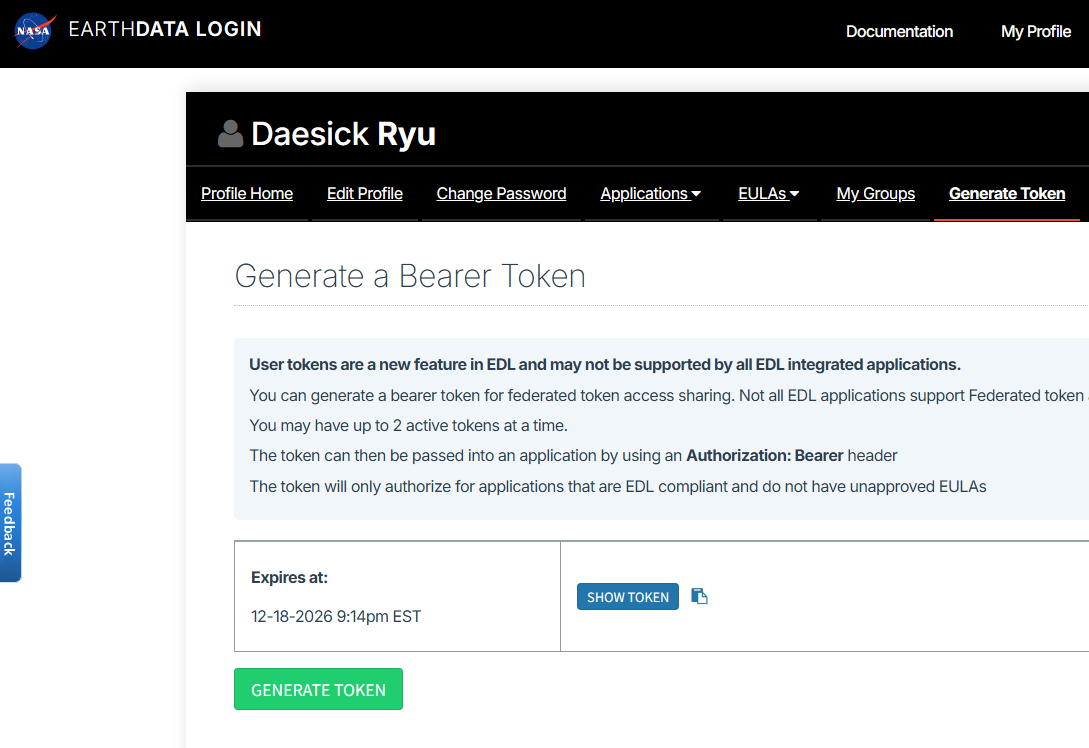
My Profile에서 ‘Generate Token’ 탭을 보면 위와 같이 내 토큰을 확인할 수 있다.
using HTTP, JSON3, NCDatasets, DataFrames, Dates, CSV, JLD2, StatsBase, ProgressMeter
using Base.Threads
const EDL_TOKEN = "여기에 EARTHDATA 인증 토큰을 입력"
const AUTH_HEADER = ["Authorization" => "Bearer $EDL_TOKEN"]
const OSCAR25_CID = "C2098858642-POCLOUD"
const MUR_CID = "C1996881146-POCLOUD"
위의 MUR_CID와 OSCAR25_CID는 각각 받을 데이터를 지정하는 번호다. 아래 코드에서는 이 번호와 날짜로 파일의 주소를 검색한 뒤, 인증 헤더를 붙여 다운로드한다.
EDL_TOKEN은 이를테면 다음과 같이 긴 문자열이다. 이미 만료되었으니 보여줄 수 있는건데, 실제 사용시에는 유출되지 않게 주의해야 한다.
eyJ0eXAiOiJKV1QiLCJvcmlnaW4iOiJFYXJ0aGRhdGEgTG9naW4iLCJzaWciOiJlZGxqd3RwdWJrZXlfb3BzIiwiYWxnIjoiUlMyNTYifQ.eyJ0eXBlIjoiVXNlciIsInVpZCI6ImRzcnl1MDgyMiIsInN1YiI6ImRzcnl1MDgyMiIsImV4cCI6MTc5NzY0NjQ5NiwiaWF0IjoxNzkyNDYyNDk2LCJpc3MiOiJodHRwczovL3Vycy5lYXJ0aGRhdGEubmFzYS5nb3YiLCJpZGVudGl0eV9wcm92aWRlciI6ImVkbF9vcHMiLCJhY3IiOiJlZGwiLCJhc3N1cmFuY2VfbGV2ZWwiOjN9.3FJrUce5xVkMqrpPemlmEncWgFossHLgPN88NVjlvNJDrR0ecCKbdR4PsijS_Px8UVlwlc2oa37TnMpNP5u_sjgLoag8EME3lTUThnMsk4kO3JSOMKVmNRci6Ce-AofN6xBVWcGp_eFyoEA7xutATS1SaumnpKm_iR98-3X3s4cWJZQYcsA_xdRprji6SbBi0zErTNlrVM3X_Wn7XCNxS-21q0KGInztAKwswNGv00C9FAvPEMBpuGjiWTCKBRFmpIDWAsb_SCRwOCaGCtv628JI3PuqsZNBUOwJjJ39vTKg5OBmWHfG5JP60FbsKlmRJFtmKiUYaAsvBoqj7cdytA
설마 싶겠지만 악의적인 사용자가 토큰을 탈취해서 서버에 요청을 폭격하듯 쏘아버리면 토큰을 빼앗긴 사람이 범인으로 지목된다.
MUR
function GHRSSTMUR(filename, day)
    cmr = "https://cmr.earthdata.nasa.gov/search/granules.umm_json"
    d1 = DateTime(day)
    d2 = d1 + Day(1)

    q = ["collection_concept_id"=>MUR_CID,
         "temporal"=>"$(d1)Z,$(d2)Z",
         "page_size"=>"10"]

    j = JSON3.read(HTTP.get(cmr; query=q, headers=AUTH_HEADER).body)

    tag = Dates.format(day, "yyyymmdd")
    urls = [u.URL for g in j.items for u in g.umm.RelatedUrls
            if u.Type == "GET DATA" && occursin(tag, u.URL)]

    isempty(urls) && error("No MUR granule found for $day")

    r = HTTP.get(urls[1]; headers=AUTH_HEADER)
    tmp = tempname() * ".nc"

    open(tmp, "w") do f
        write(f, r.body)
    end

    ds = NCDataset(tmp)

    lat = ds["lat"][:]
    lon = ds["lon"][:]
    sst0 = ds["analysed_sst"][:, :, 1]

    target_lon = collect(-170.0:0.25:-120.0)
    target_lat = collect(-5.0:0.25:5.0)

    ilon = [argmin(abs.(lon .- x)) for x in target_lon]
    ilat = [argmin(abs.(lat .- x)) for x in target_lat]

    sst = Float64.(sst0[ilon, ilat]) .- 273.15

    close(ds)
    rm(tmp)

    sst = reshape(sst, length(target_lon), length(target_lat), 1)

    NCDataset(filename, "c") do out
        defDim(out, "lon", length(target_lon))
        defDim(out, "lat", length(target_lat))
        defDim(out, "time", 1)

        defVar(out, "lon", target_lon, ("lon",))
        defVar(out, "lat", target_lat, ("lat",))
        defVar(out, "time", [d1], ("time",))

        defVar(out, "analysed_sst", sst,
               ("lon", "lat", "time"))

        out["analysed_sst"].attrib["units"] = "degree_Celsius"
    end
end


day_ = setdiff((Date(2020, 1, 1):Date(2026, 1, 16)),
       [Date(d[1:end-4]) for d in readdir("G:/seasurface/podaacT")])
@showprogress for day in day_
    try
        if !isfile("G:/seasurface/podaacT/$day.nc4")
            GHRSSTMUR("G:/seasurface/podaacT/$day.nc4", day)
        else
            @info "Skipping GHRSSTMUR for $day"
        end
    catch e
        @warn "GHRSSTMUR failed for $day: $e"
    end
end
가령 위의 코드는 2020년 1월 1일부터 2026년 1월 16일까지의 해수면온도를 받아내는 코드다. 이미 저장된 날짜는 제외하고, 다운로드한 파일에서 필요한 영역을 추출한다.
target_lon과 target_lat은 각각 경도와 위도를 지정한다. 여기서는 0.25° 간격의 격자점에 가장 가까운 원본 격자점을 선택하고, 온도에서 273.15를 빼서 섭씨로 바꾸고 있다. 원본 파일 전체를 받은 다음 영역을 추출하는 방식이라는 점에 주의하자.
OSCAR
function OSCAR25(filename, day)
    cmr = "https://cmr.earthdata.nasa.gov/search/granules.umm_json"
    cid = OSCAR25_CID

    t1 = DateTime(day)
    t2 = t1 + Day(1) - Second(1)

    q = ["collection_concept_id"=>cid,
         "temporal"=>"$(t1)Z,$(t2)Z",
         "page_size"=>"10"]

    j = JSON3.read(HTTP.get(cmr; query=q, headers=AUTH_HEADER).body)

    tag = Dates.format(day, "yyyymmdd")
    urls = [u.URL for g in j.items for u in g.umm.RelatedUrls
            if u.Type == "GET DATA" && occursin(tag, u.URL)]

    isempty(urls) && error("No OSCAR granule found for $day")

    r = HTTP.get(urls[1]; headers=AUTH_HEADER)
    tmp = tempname() * ".nc"

    open(tmp, "w") do f
        write(f, r.body)
    end

    ds = NCDataset(tmp)

    lat = ds["lat"][:]
    lon = ds["lon"][:]

    ilat = findall((-5 .<= lat) .& (lat .<= 5))
    ilon = findall((190 .<= lon) .& (lon .<= 240))

    u = Array(ds["ug"][ilat, ilon, 1])
    v = Array(ds["vg"][ilat, ilon, 1])

    close(ds)
    rm(tmp)

    u = reshape(permutedims(u, (2, 1)), length(ilon), length(ilat), 1)
    v = reshape(permutedims(v, (2, 1)), length(ilon), length(ilat), 1)

    lon_out = lon[ilon] .- 360

    NCDataset(filename, "c") do out
        defDim(out, "lon", length(ilon))
        defDim(out, "lat", length(ilat))
        defDim(out, "time", 1)

        defVar(out, "lon", lon_out, ("lon",))
        defVar(out, "lat", lat[ilat], ("lat",))
        defVar(out, "time", [string(day)], ("time",))

        defVar(out, "u", u, ("lon", "lat", "time"))
        defVar(out, "v", v, ("lon", "lat", "time"))

        out["u"].attrib["units"] = "m s-1"
        out["v"].attrib["units"] = "m s-1"
    end
end

@showprogress for day in (Date(2020, 1, 1):Date(2026, 8, 1))
    try
        if !isfile("G:/seasurface/podaacUV/$day.nc4")
            OSCAR25("G:/seasurface/podaacUV/$day.nc4", day)
        end
    catch e
        @warn "OSCAR25 failed for $day: $e"
    end
end
한편 해류는 ug와 vg를 가져온다. 위의 코드에서는 경도가 0~360°로 주어지는 것을 고려해서 190~240°를 선택하고, 저장할 때 360°를 빼서 -170~-120°로 맞추고 있다.
또한 원본의 위도 × 경도 순서를 바꾸어서, 앞서 저장한 해수면온도와 같이 경도 × 위도 × 시간 순서로 저장한다.
NCDatasets.jl
days = Date.(first.(split.(readdir("G:/seasurface/podaacT"), ".")))
temp = NCDataset("G:/seasurface/podaacT/2020-01-01.nc4")
D = days
X = temp["lon"][:]
Y = temp["lat"][:]
nX = length(X)
nY = length(Y)
close(temp)

nino34T = DataFrame(zeros(length(days), nX*nY), ["k$k" for k in 1:nX*nY])
nino34U, nino34V = deepcopy(nino34T), deepcopy(nino34T)
T = zeros(nY, nX, length(days))
U, V = deepcopy(T), deepcopy(T)
@showprogress for t in eachindex(days)
    day = days[t]
    filenameT = "G:/seasurface/podaacT/$(string(day)).nc4"
    filenameUV = "G:/seasurface/podaacUV/$(string(day)).nc4"

    NCDataset(filenameT) do ds
        T[:, :, t] = ds["analysed_sst"][:, :, 1]'
        nino34T[t, :] = ds["analysed_sst"][:, :, 1][:]'
    end
    NCDataset(filenameUV) do ds
        U[:, :, t] = ds["u"][:, :, 1]'
        V[:, :, t] = ds["v"][:, :, 1]'
        nino34U[t, :] = U[:, :, t]
        nino34V[t, :] = V[:, :, t]
    end
end
저장한 파일은 NCDatasets.jl로 다시 읽을 수 있다. 위의 코드에서는 해수면온도와 두 방향의 해류를 각각 T, U, V에 담고 있다. 이때 배열은 위도 × 경도 × 시간 순서로 바꾸고, CSV로 저장할 데이터프레임도 함께 만든다.
저장
time = DataFrame(date = D)
CSV.write("G:/seasurface/nino34T.csv", [time nino34T])
CSV.write("G:/seasurface/nino34U.csv", [time nino34U])
CSV.write("G:/seasurface/nino34V.csv", [time nino34V])
CSV.jl을 통해 날짜와 격자별 값을 데이터프레임으로 저장할 수 있다.
전체 코드
using HTTP, JSON3, NCDatasets, DataFrames, Dates, CSV, JLD2, StatsBase, ProgressMeter
using Base.Threads
const EDL_TOKEN = "여기에 EARTHDATA 인증 토큰을 입력"
const AUTH_HEADER = ["Authorization" => "Bearer $EDL_TOKEN"]
const OSCAR25_CID = "C2098858642-POCLOUD"
const MUR_CID = "C1996881146-POCLOUD"

function GHRSSTMUR(filename, day)
    cmr = "https://cmr.earthdata.nasa.gov/search/granules.umm_json"
    d1 = DateTime(day)
    d2 = d1 + Day(1)

    q = ["collection_concept_id"=>MUR_CID,
         "temporal"=>"$(d1)Z,$(d2)Z",
         "page_size"=>"10"]

    j = JSON3.read(HTTP.get(cmr; query=q, headers=AUTH_HEADER).body)

    tag = Dates.format(day, "yyyymmdd")
    urls = [u.URL for g in j.items for u in g.umm.RelatedUrls
            if u.Type == "GET DATA" && occursin(tag, u.URL)]

    isempty(urls) && error("No MUR granule found for $day")

    r = HTTP.get(urls[1]; headers=AUTH_HEADER)
    tmp = tempname() * ".nc"

    open(tmp, "w") do f
        write(f, r.body)
    end

    ds = NCDataset(tmp)

    lat = ds["lat"][:]
    lon = ds["lon"][:]
    sst0 = ds["analysed_sst"][:, :, 1]

    target_lon = collect(-170.0:0.25:-120.0)
    target_lat = collect(-5.0:0.25:5.0)

    ilon = [argmin(abs.(lon .- x)) for x in target_lon]
    ilat = [argmin(abs.(lat .- x)) for x in target_lat]

    sst = Float64.(sst0[ilon, ilat]) .- 273.15

    close(ds)
    rm(tmp)

    sst = reshape(sst, length(target_lon), length(target_lat), 1)

    NCDataset(filename, "c") do out
        defDim(out, "lon", length(target_lon))
        defDim(out, "lat", length(target_lat))
        defDim(out, "time", 1)

        defVar(out, "lon", target_lon, ("lon",))
        defVar(out, "lat", target_lat, ("lat",))
        defVar(out, "time", [d1], ("time",))

        defVar(out, "analysed_sst", sst,
               ("lon", "lat", "time"))

        out["analysed_sst"].attrib["units"] = "degree_Celsius"
    end
end


day_ = setdiff((Date(2020, 1, 1):Date(2026, 1, 16)),
       [Date(d[1:end-4]) for d in readdir("G:/seasurface/podaacT")])
@showprogress for day in day_
    try
        if !isfile("G:/seasurface/podaacT/$day.nc4")
            GHRSSTMUR("G:/seasurface/podaacT/$day.nc4", day)
        else
            @info "Skipping GHRSSTMUR for $day"
        end
    catch e
        @warn "GHRSSTMUR failed for $day: $e"
    end
end


function OSCAR25(filename, day)
    cmr = "https://cmr.earthdata.nasa.gov/search/granules.umm_json"
    cid = OSCAR25_CID

    t1 = DateTime(day)
    t2 = t1 + Day(1) - Second(1)

    q = ["collection_concept_id"=>cid,
         "temporal"=>"$(t1)Z,$(t2)Z",
         "page_size"=>"10"]

    j = JSON3.read(HTTP.get(cmr; query=q, headers=AUTH_HEADER).body)

    tag = Dates.format(day, "yyyymmdd")
    urls = [u.URL for g in j.items for u in g.umm.RelatedUrls
            if u.Type == "GET DATA" && occursin(tag, u.URL)]

    isempty(urls) && error("No OSCAR granule found for $day")

    r = HTTP.get(urls[1]; headers=AUTH_HEADER)
    tmp = tempname() * ".nc"

    open(tmp, "w") do f
        write(f, r.body)
    end

    ds = NCDataset(tmp)

    lat = ds["lat"][:]
    lon = ds["lon"][:]

    ilat = findall((-5 .<= lat) .& (lat .<= 5))
    ilon = findall((190 .<= lon) .& (lon .<= 240))

    u = Array(ds["ug"][ilat, ilon, 1])
    v = Array(ds["vg"][ilat, ilon, 1])

    close(ds)
    rm(tmp)

    u = reshape(permutedims(u, (2, 1)), length(ilon), length(ilat), 1)
    v = reshape(permutedims(v, (2, 1)), length(ilon), length(ilat), 1)

    lon_out = lon[ilon] .- 360

    NCDataset(filename, "c") do out
        defDim(out, "lon", length(ilon))
        defDim(out, "lat", length(ilat))
        defDim(out, "time", 1)

        defVar(out, "lon", lon_out, ("lon",))
        defVar(out, "lat", lat[ilat], ("lat",))
        defVar(out, "time", [string(day)], ("time",))

        defVar(out, "u", u, ("lon", "lat", "time"))
        defVar(out, "v", v, ("lon", "lat", "time"))

        out["u"].attrib["units"] = "m s-1"
        out["v"].attrib["units"] = "m s-1"
    end
end

@showprogress for day in (Date(2020, 1, 1):Date(2026, 8, 1))
    try
        if !isfile("G:/seasurface/podaacUV/$day.nc4")
            OSCAR25("G:/seasurface/podaacUV/$day.nc4", day)
        end
    catch e
        @warn "OSCAR25 failed for $day: $e"
    end
end


days = Date.(first.(split.(readdir("G:/seasurface/podaacT"), ".")))
temp = NCDataset("G:/seasurface/podaacT/2020-01-01.nc4")
D = days
X = temp["lon"][:]
Y = temp["lat"][:]
nX = length(X)
nY = length(Y)
close(temp)

nino34T = DataFrame(zeros(length(days), nX*nY), ["k$k" for k in 1:nX*nY])
nino34U, nino34V = deepcopy(nino34T), deepcopy(nino34T)
T = zeros(nY, nX, length(days))
U, V = deepcopy(T), deepcopy(T)
@showprogress for t in eachindex(days)
    day = days[t]
    filenameT = "G:/seasurface/podaacT/$(string(day)).nc4"
    filenameUV = "G:/seasurface/podaacUV/$(string(day)).nc4"

    NCDataset(filenameT) do ds
        T[:, :, t] = ds["analysed_sst"][:, :, 1]'
        nino34T[t, :] = ds["analysed_sst"][:, :, 1][:]'
    end
    NCDataset(filenameUV) do ds
        U[:, :, t] = ds["u"][:, :, 1]'
        V[:, :, t] = ds["v"][:, :, 1]'
        nino34U[t, :] = U[:, :, t]
        nino34V[t, :] = V[:, :, t]
    end
end

time = DataFrame(date = D)
CSV.write("G:/seasurface/nino34T.csv", [time nino34T])
CSV.write("G:/seasurface/nino34U.csv", [time nino34U])
CSV.write("G:/seasurface/nino34V.csv", [time nino34V])


∂x(M) = (circshift(M, (0, -1)) - circshift(M, (0, 1)))
∂y(M) = (circshift(M, (-1, 0)) - circshift(M, (1, 0)))
∂xx(M) = (circshift(M, (0, -1)) - 2M + circshift(M, (0, 1)))
∂yy(M) = (circshift(M, (-1, 0)) - 2M + circshift(M, (1, 0)))

_T, _U, _V = deepcopy(T), deepcopy(U), deepcopy(V)
@time for M = ["T", "U", "V"]
"""
begin
    _d$(M) = diff(_$(M), dims = 3)
    _$(M)x = ∂x(_$(M))[:, :, 1:end-1]
    _$(M)y = ∂y(_$(M))[:, :, 1:end-1]
    _$(M)xx = ∂xx(_$(M))[:, :, 1:end-1]
    _$(M)yy = ∂yy(_$(M))[:, :, 1:end-1]

    _$(M) = _$(M)[:, :, 1:end-1]
end
""" |> Meta.parse |> eval
end

JLD2.@save "G:/seasurface/nino34TUV.jld2" D X Y nX nY _dT _dU _dV _T _U _V _Tx _Ty _Txx _Tyy _Ux _Uy _Uxx _Uyy _Vx _Vy _Vxx _Vyy