시계열의 복잡도를 측정하는 지표: 퍼뮤테이션 엔트로피
정의 1
시계열 $\left\{ y_{t} \right\}_{t=1}^{T}$ 이 주어져 있다고 하자. 오더order $n$ 개의 연속된 시점으로 묶인 벡터 $\left( y_{t+1}, \cdots , y_{t+n} \right)$ 를 고려하려 하고, 이러한 벡터는 총 $T - n + 1$ 개 있을 것이다. 벡터의 성분을 크기 순서대로 $1$ 부터 $n$ 까지의 정수를 부여한 랭킹ranking의 벡터 $\pi$ 는 순열로 계산했을 때 정확히 $n!$ 종류가 존재할 수 있을 것이다. $p (\pi)$ 는 다음과 같이 벡터가 $\pi$ 유형에 속하는 비율로 정의된다. $$ p (\pi) := \frac{ \left| \left\{ t : \left( y_{t+1}, \cdots , y_{t+n} \right) \text{ is of type } \pi \right\} \right| }{T - n + 1} $$ 여기서 $\left| \cdot \right|$ 는 집합의 기수다. $n$ 에 대해 퍼뮤테이션 엔트로피permutation entropy $H(n)$ 은 다음과 같이 정의된다. $$ H (n) := - \sum_{\pi} p (\pi) \log p (\pi) $$
설명
사실 정의에서 $\pi$ 가 뭔지만 잘 파악이 되면 엔트로피의 정의 자체는 샤넌 엔트로피와 동일하기 때문에 전혀 어렵지 않다. 퍼뮤테이션 엔트로피는 시계열이 가장 단순한 경우, 이를테면 증가하기만 하거나 감소하기만 할 때 $0$ 이 되고 무작위성이 강한 카오스나 브라운 모션 등에서는 큰 값을 취할 것이다.
한편 $0 \le H(n) \le \log n!$ 이라고는 해도 복잡도와는 무관하게 $n$ 이 커질수록 $H(n)$ 이 증가하기도 한다. 그래서 개념적으로는 $H$ 로 충분하지만, 보통 심볼 당 퍼뮤테이션 엔트로피permutation entropy per symbol $h_{n}$ 을 다음과 같이 정의해서 쓴다. $$ h_{n} := \frac{H(n)}{n-1} $$
다음은 로지스틱 맵에서 바이퍼케이션 파라미터 $r \in [3.5, 4]$ 를 바꿔가며 그린 바이퍼케이션 다이어그램과 그에 대응하는 랴푸노프 지수 $\lambda$, 그리고 $h_{6}$ 와 $h_{12}$ 을 비교한 것이다.
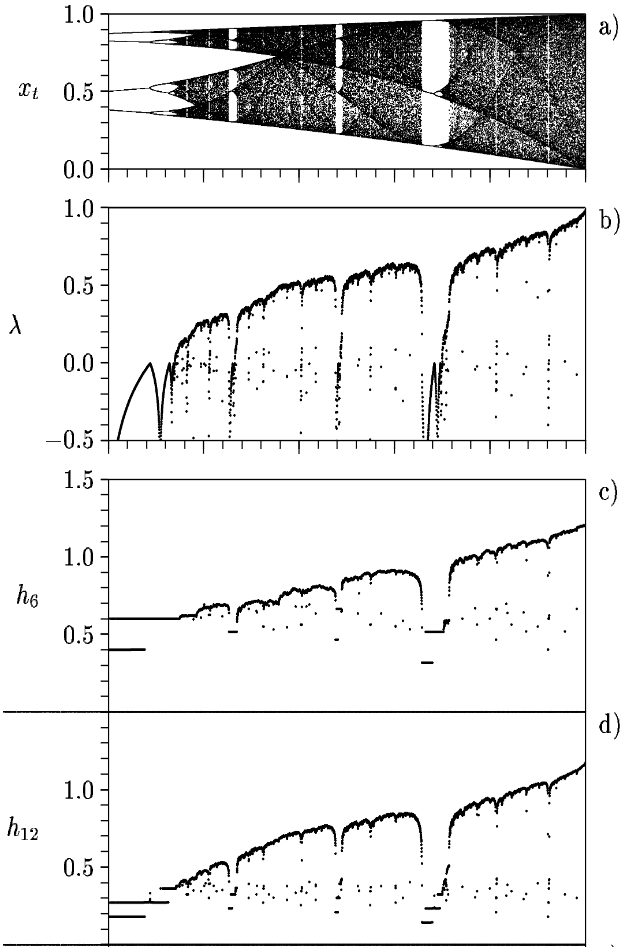
$h_{6}$ 와 $h_{12}$ 는 $\lambda$ 와 거의 유사한 형태를 보이되, $h_{12}$ 가 더 유사하게 나타나는 것을 확인할 수 있다. 랴푸노프 지수와 퍼뮤테이션 엔트로피의 개념이나 정의가 판이하게 다른 것을 생각해보면 이정도로 비슷한 것도 놀라운 일이다.
물론 $\lambda$ 는 $0$ 보다 크냐 작으냐의 비교로써 캐어릭하다는 것을 명확히 짚어주고 $h_{n}$ 은 그 기준점이 명료하지 않다는 차이점은 있으나, 짧은 선분으로써 피리어딕한 구간이 어디에 있는지 짐작 정도는 할 수 있다.
Bandt, C., & Pompe, B. (2002). Permutation entropy: a natural complexity measure for time series. Physical review letters, 88(17), 174102. https://doi.org/10.1103/PhysRevLett.88.174102 http://materias.df.uba.ar/dnla2019c1/files/2019/03/permutation_entropy.pdf ↩︎