バッチ正規化
導入1
学習データ$X = \left\{ \mathbf{x}_{1}, \cdots, \mathbf{x}_{N} \right\}$が与えられたとする。これを$B = \left\{ B_{1}, \dots, B_{m} \right\}$ $(|B_{i}| = n)$のようにミニバッチに分け、$B_{i}$の$k$番目のデータを$\mathbf{x}_{i,k}$と書く。$i$番目のバッチ$B_{i}$について、$f$をニューラルネットワークの適当な一部分、$H$をその層の出力次元とし、$k$番目のデータに対するその層の出力を$\mathbf{a}^{k} := f(\mathbf{x}_{i,k}) \in \mathbb{R}^{H}$とする。これらを行として積み重ねた行列を$\mathbf{A}$とする。
$$ \mathbf{A} = \begin{bmatrix} \left( \mathbf{a}^{1} \right)^{\mathsf{T}} \\ \left( \mathbf{a}^{2} \right)^{\mathsf{T}} \\ \vdots \\ \left( \mathbf{a}^{n} \right)^{\mathsf{T}} \end{bmatrix} = \begin{bmatrix} f(\mathbf{x}_{i,1})^{\mathsf{T}} \\ f(\mathbf{x}_{i,2})^{\mathsf{T}} \\ \vdots \\ f(\mathbf{x}_{i,n})^{\mathsf{T}} \end{bmatrix} \in \mathbb{R}^{n \times H} $$
すなわち$\mathbf{A}$は$k$番目の行が$k$番目のデータに対する出力$\mathbf{a}^{k}$である行列であり、その$(k, j)$成分$\left[ \mathbf{A} \right]_{kj} = \left[ \mathbf{a}^{k} \right]_{j}$は$k$番目のデータの$j$番目の成分である。
$\mathbf{1} \in \mathbb{R}^{n}$をすべての成分が$1$のベクトルとする。成分$j = 1, \dots, H$ごとにバッチ方向に、言い換えれば$\mathbf{A}$の列ごとに計算した平均と分散は次のとおりである。
$$ \mu_{j}(\mathbf{A}) := \frac{1}{n} \sum_{k=1}^{n} \left[ \mathbf{A} \right]_{kj} , \qquad \sigma_{j}^{2}(\mathbf{A}) := \frac{1}{n} \sum_{k=1}^{n} \left( \left[ \mathbf{A} \right]_{kj} - \mu_{j}(\mathbf{A}) \right)^{2} $$
これらを集めたベクトルを$\boldsymbol{\mu}(\mathbf{A})$、$\boldsymbol{\sigma}^{2}(\mathbf{A}) \in \mathbb{R}^{H}$と書くと、平均は$\mathbf{A}$の列ごとの平均であるから、行列積で簡単に表される。
$$ \boldsymbol{\mu}(\mathbf{A}) = \frac{1}{n} \mathbf{A}^{\mathsf{T}} \mathbf{1} = \begin{bmatrix} \mu_{1}(\mathbf{A}) \\ \vdots \\ \mu_{H}(\mathbf{A}) \end{bmatrix} $$
標準偏差は$\sigma_{j}(\mathbf{A}) := \sqrt{ \sigma_{j}^{2}(\mathbf{A}) }$と書く。
定義
スケールscale$\boldsymbol{\gamma} \in \mathbb{R}^{H}$とシフトshift$\boldsymbol{\beta} \in \mathbb{R}^{H}$に対して、次のような関数$\operatorname{BN} : \mathbb{R}^{n \times H} \to \mathbb{R}^{n \times H}$をバッチ正規化batch normalizationという。
$$ \operatorname{BN}(\mathbf{A}) := \begin{bmatrix} \gamma_{1} \dfrac{ \left[ \mathbf{A} \right]_{11} - \mu_{1}(\mathbf{A}) }{ \sigma_{1}(\mathbf{A}) } + \beta_{1} & \cdots & \gamma_{H} \dfrac{ \left[ \mathbf{A} \right]_{1H} - \mu_{H}(\mathbf{A}) }{ \sigma_{H}(\mathbf{A}) } + \beta_{H} \\ \vdots & \ddots & \vdots \\ \gamma_{1} \dfrac{ \left[ \mathbf{A} \right]_{n1} - \mu_{1}(\mathbf{A}) }{ \sigma_{1}(\mathbf{A}) } + \beta_{1} & \cdots & \gamma_{H} \dfrac{ \left[ \mathbf{A} \right]_{nH} - \mu_{H}(\mathbf{A}) }{ \sigma_{H}(\mathbf{A}) } + \beta_{H} \end{bmatrix} $$
これは、$j$番目の列全体をその列の平均$\mu_{j}(\mathbf{A})$と標準偏差$\sigma_{j}(\mathbf{A})$で標準化した後、列ごとに$\gamma_{j}$倍して$\beta_{j}$を加えるものである。
説明
$X$の平均と標準偏差による$Z = \dfrac{X - \mu}{\sigma}$のような変換は、統計学では標準化standardizationと呼ばれるものだが、機械学習の分野ではこれを正規化normalizationと呼ぶ。データに施すあらゆる変換を区別なく正規化と呼ぶ傾向が強い。
一方、対角行列を左から掛けることが、対角成分を相手の行列の各行全体に掛けることと同じであるように、対角行列を右から掛けることは、対角成分を相手の行列の各列全体に掛けることと同じである。したがって対角行列$\mathbf{D}(\mathbf{A}) \in \mathbb{R}^{H \times H}$を次のようにおくと、
$$ \mathbf{D}(\mathbf{A}) := \diag \begin{bmatrix} \dfrac{\gamma_{1}}{\sigma_{1}(\mathbf{A})} & \cdots & \dfrac{\gamma_{H}}{\sigma_{H}(\mathbf{A})} \end{bmatrix} $$
上の定義を次のように表すことができる。
$$ \operatorname{BN} (\mathbf{A}) = \left( \mathbf{A} - \mathbf{1} \boldsymbol{\mu}(\mathbf{A})^{\mathsf{T}} \right) \mathbf{D}(\mathbf{A}) + \mathbf{1} \boldsymbol{\beta}^{\mathsf{T}} $$
実際の実装では、$\sigma_{j}(\mathbf{A}) = 0$のときに$0$で割ることを防ぐため、分母に小さな$\epsilon > 0$を加える。すなわち$\mathbf{D}(\mathbf{A})$の代わりに次の$\mathbf{D}_{\epsilon}(\mathbf{A})$を使う。
$$ \mathbf{D}_{\epsilon}(\mathbf{A}) := \begin{bmatrix} \dfrac{\gamma_{1}}{\sqrt{\sigma_{1}^{2}(\mathbf{A}) + \epsilon}} & & \\ & \ddots & \\ & & \dfrac{\gamma_{H}}{\sqrt{\sigma_{H}^{2}(\mathbf{A}) + \epsilon}} \end{bmatrix} $$
$$ \operatorname{BN} (\mathbf{A}) = \left( \mathbf{A} - \mathbf{1} \boldsymbol{\mu}(\mathbf{A})^{\mathsf{T}} \right) \mathbf{D}_{\epsilon}(\mathbf{A}) + \mathbf{1} \boldsymbol{\beta}^{\mathsf{T}} $$
成分で書き下すと次のとおりである。
$$ \left[ \operatorname{BN} (\mathbf{A}) \right]_{kj} = \gamma_{j} \dfrac{ \left[ \mathbf{A} \right]_{kj} - \mu_{j}(\mathbf{A}) }{ \sqrt{ \sigma_{j}^{2}(\mathbf{A}) + \epsilon } } + \beta_{j} $$
$\boldsymbol{\gamma}$と$\boldsymbol{\beta}$は学習されるパラメータである。$\mathbf{D}(\mathbf{A})$と$\boldsymbol{\mu}(\mathbf{A})$が$\mathbf{A}$のすべての行に依存するので、$\operatorname{BN}(\mathbf{A})$の$k$番目の行は$\mathbf{a}^{k}$だけでは決まらない。
推論時には異なる動作をする。入力バッチによって出力が変わってはならないので、決定論的なdeterministic出力を得るためには、バッチに関係なく固定された平均と分散が必要である。そのために、学習時にミニバッチの平均と分散を移動平均で計算しておき、推論時に使用する。
提案された論文では、学習が進む間に各層に入る入力の分布が変わり続ける現象を内部共変量シフトinternal covariate shiftと呼び、バッチ正規化がこれを減らして学習を安定させると説明している。
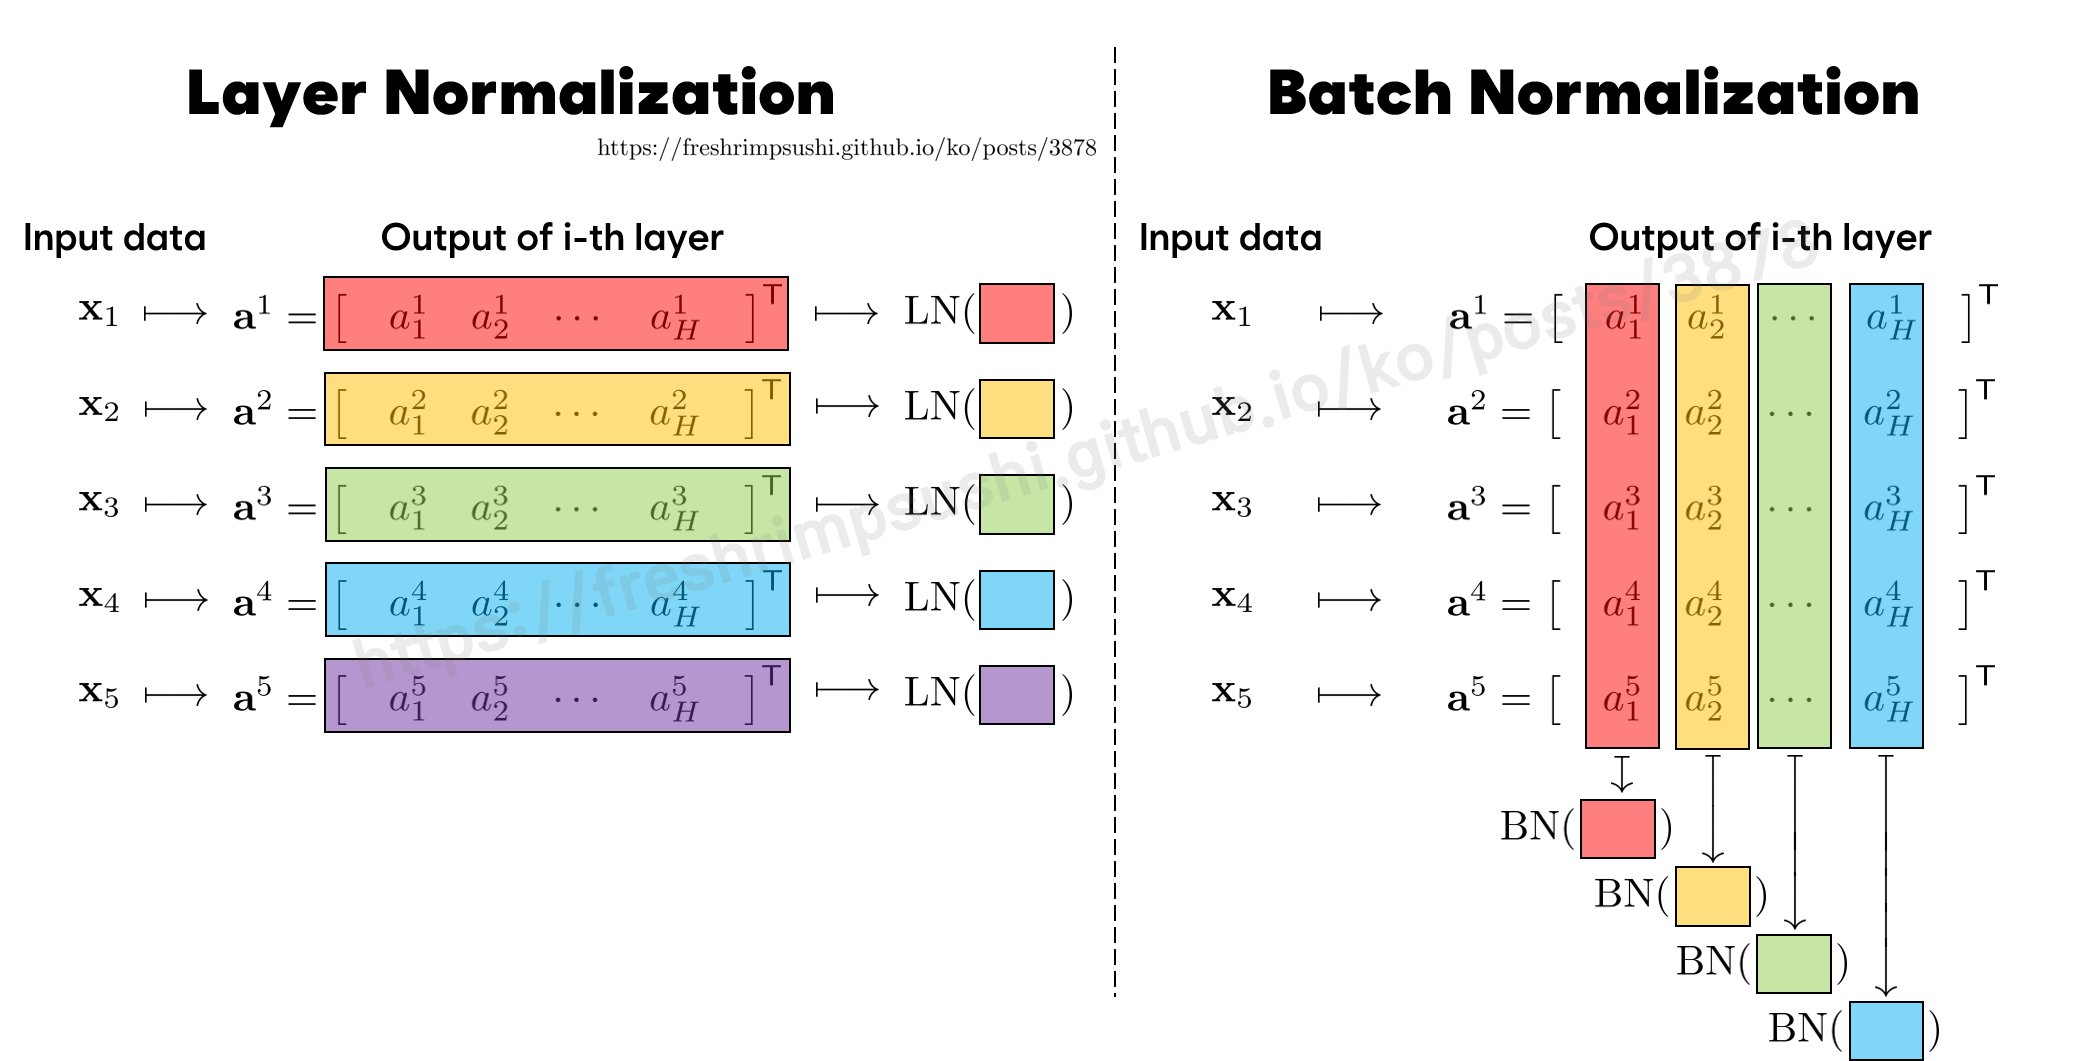
層正規化と比較してどのように動作するかを視覚的に示すと以下のとおりである。
関連リンク
Sergey Ioffe, and Christian Szegedy. Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift. Proceedings of the 32nd International Conference on Machine Learning (2015). https://arxiv.org/abs/1502.03167 ↩︎