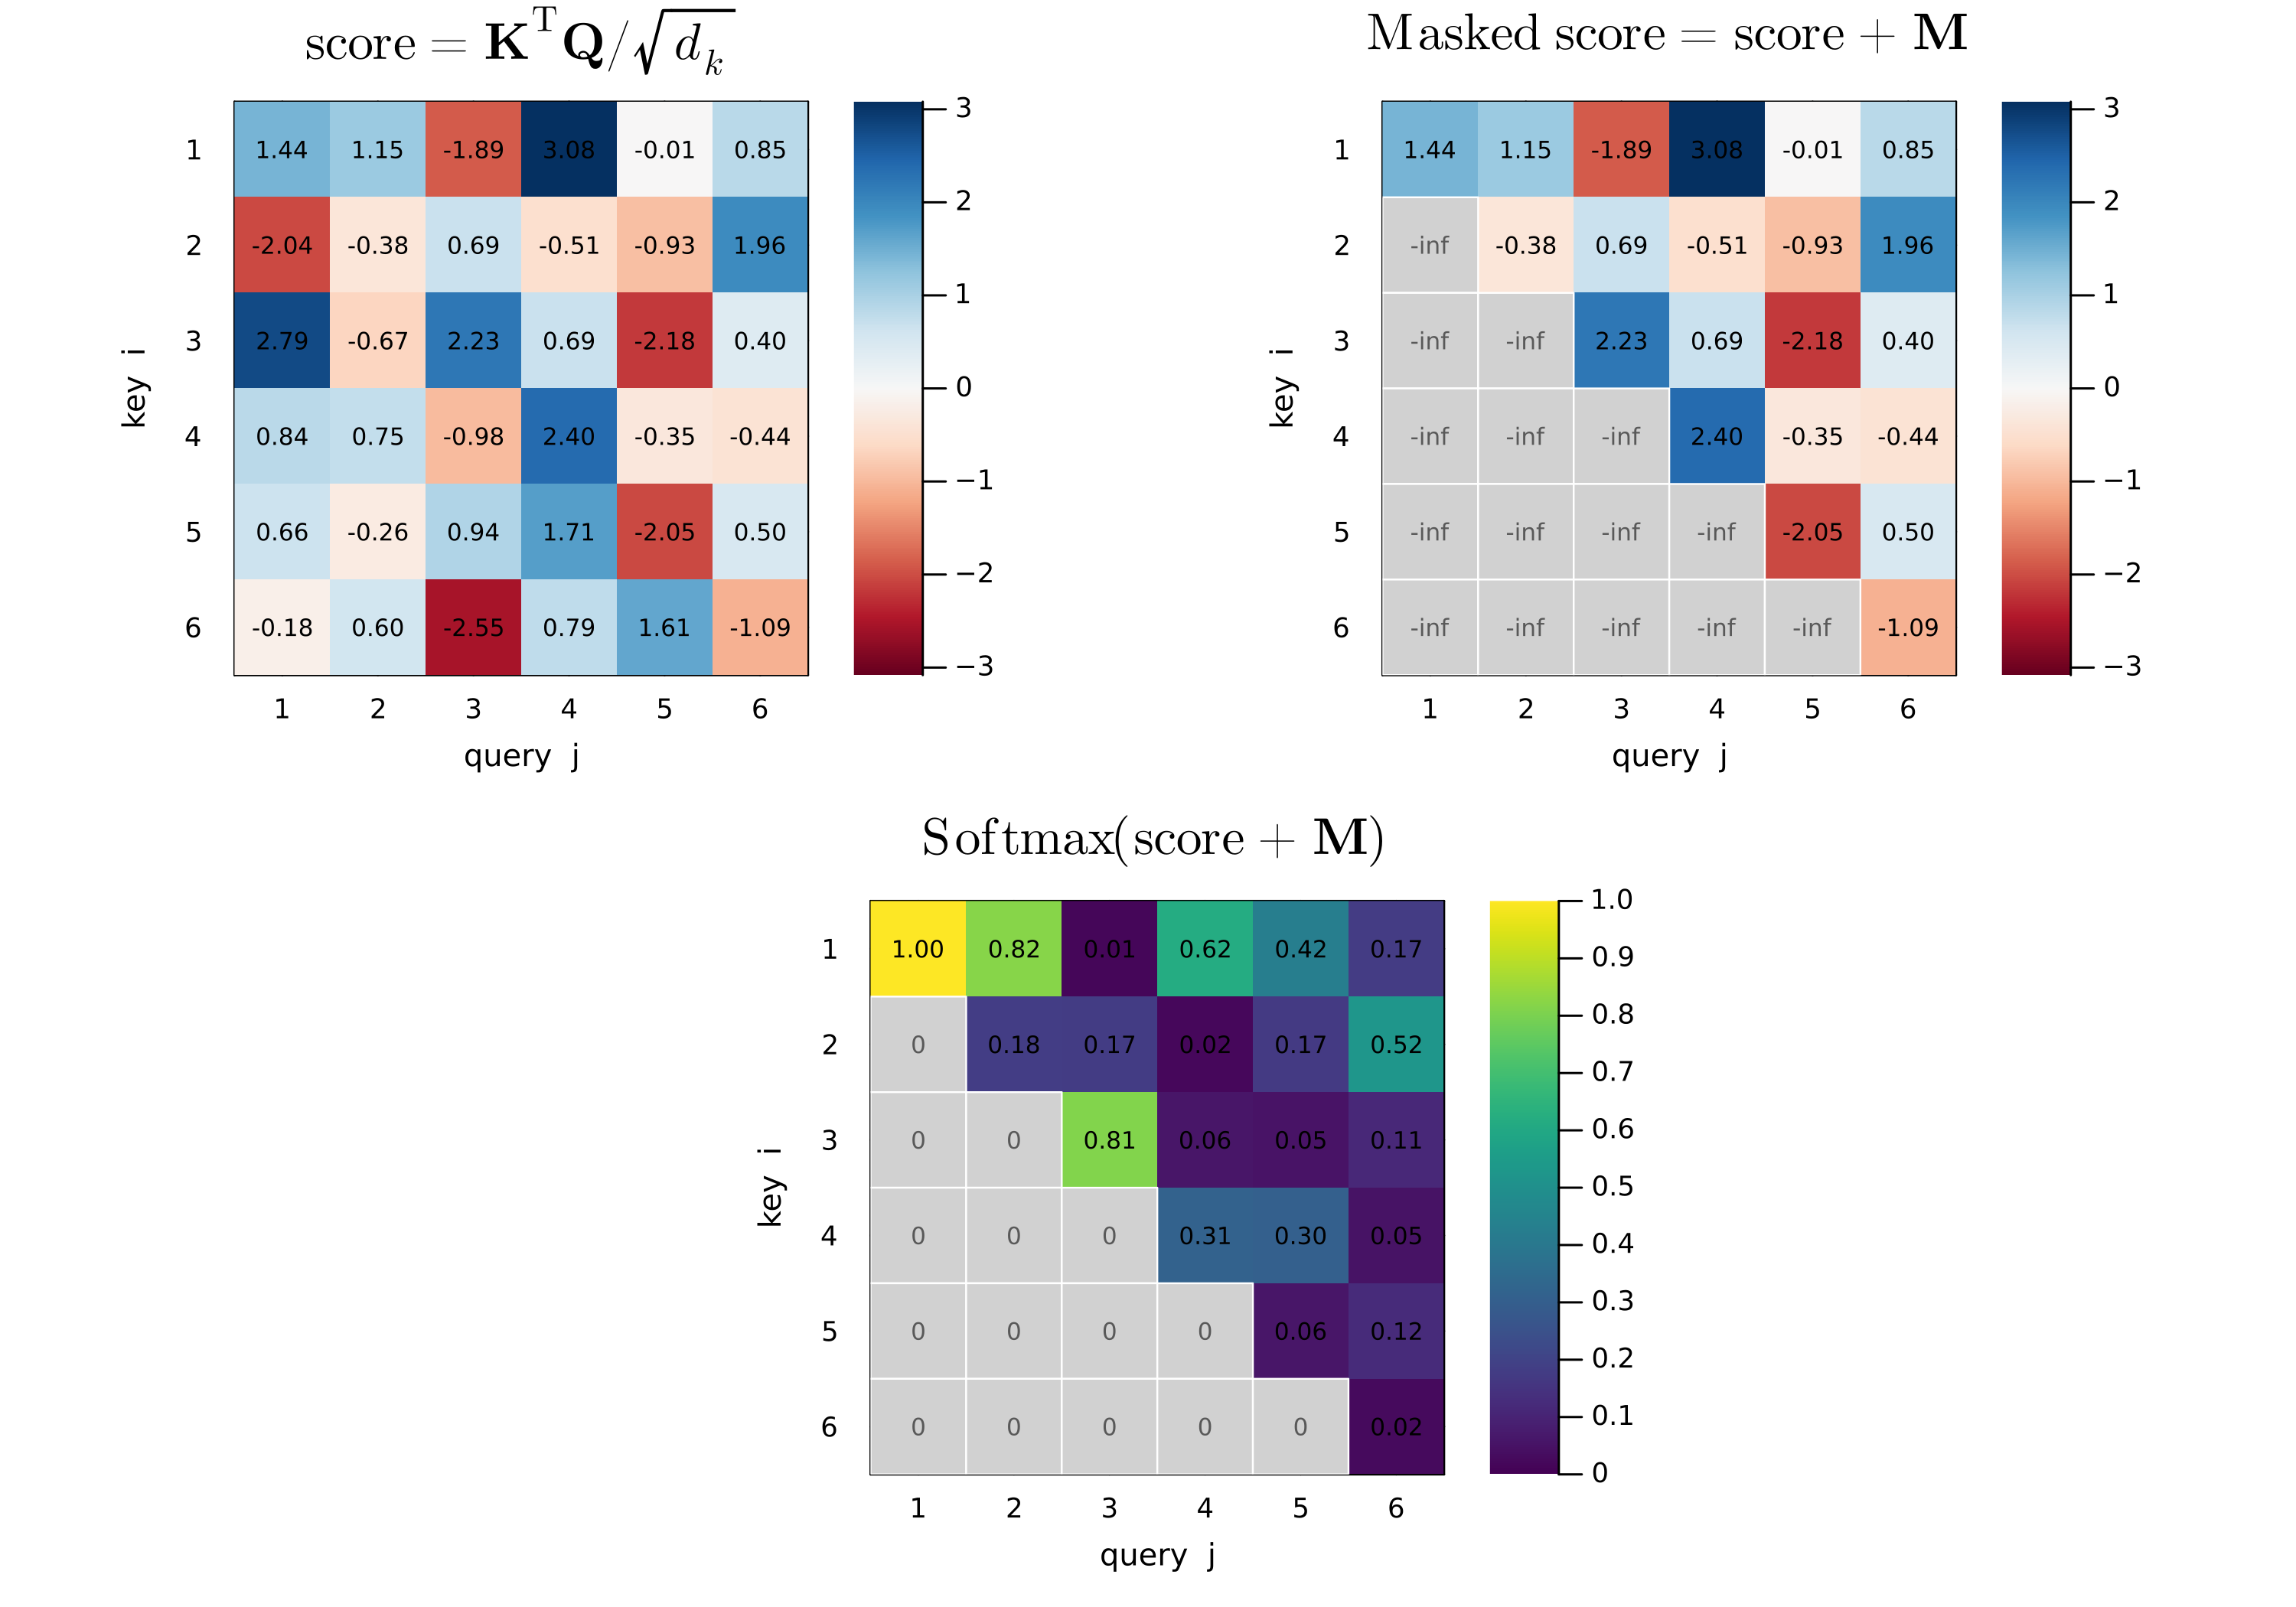
マスクドアテンション
定義
それぞれクエリ、キー、バリューと呼ばれる三つの行列$\mathbf{Q} \in M^{d_{k} \times n}$、$\mathbf{K} \in M^{d_{k} \times m}$、$\mathbf{V} \in M^{d_{v} \times m}$が与えられたとする。成分が$0$または$-\infty$である行列$\mathbf{M} \in M^{m \times n}$をマスクmaskといい、次のように定義される関数をマスクドアテンションmasked attentionという。
$$ \operatorname{MaskedAttention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) := \mathbf{V} \operatorname{Softmax} \left( \frac{\mathbf{K}^{\mathsf{T}} \mathbf{Q}}{\sqrt{d_{k}}} + \mathbf{M} \right) $$
ここで$\operatorname{Softmax}$は、与えられた行列$\mathbf{X} = \begin{bmatrix} \mathbf{x}_{1} & \cdots & \mathbf{x}_{N}\end{bmatrix}$について、各列ベクトルにソフトマックス$\operatorname{softmax}$を適用し、各列の和が$1$になるようにする関数をいう。
$$ \operatorname{Softmax}(\mathbf{X}) := \begin{bmatrix} \underset{\vert}{\overset{\vert}{\operatorname{softmax}(\mathbf{x}_{1})}} & \cdots & \underset{\vert}{\overset{\vert}{\operatorname{softmax}(\mathbf{x}_{N})}} \end{bmatrix} $$
説明
$[\mathbf{M}]_{ij} = 0$であるとは$\operatorname{score}(\mathbf{k}_{i}, \mathbf{q}_{j})$をそのまま残すということであり、$[\mathbf{M}]_{ij} = -\infty$であるとは$\operatorname{score}(\mathbf{k}_{i}, \mathbf{q}_{j})$の値を補正して$-\infty$に強制するという意味である。$e^{-\infty} = 0$なので、ソフトマックスの定義により、マスクされた成分はソフトマックスを通過するとアテンション確率がちょうど$0$になる。つまりマスキングとは、クエリが特定のキー/バリューを見られないように強制的に覆い隠す仕組みである。
トランスフォーマーの論文では、デコーダの最初のサブ層において、クエリが自分自身とそれ以前のキーだけを見られるようにする因果マスクcausal maskを使用する。すなわち、$j$番目のクエリが$i$番目のキーを参照できるかどうかは、$i \gt j$であるかどうかによって決まる。これを関数として表すと以下のようになる。
$$ \begin{bmatrix} \operatorname{Mask}(\mathbf{K}^{\mathsf{T}} \mathbf{Q}/ \sqrt{d_{k}}) \end{bmatrix}_{ij} = \begin{cases} -\infty & i \gt j \\ \mathbf{k}_{i}^{\mathsf{T}} \mathbf{q}_{j} / \sqrt{d_{k}} & i \le j \end{cases} $$
$$ \operatorname{MaskedAttention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \mathbf{V} \operatorname{Softmax} \circ \operatorname{Mask} \left( \frac{\mathbf{K}^{\mathsf{T}} \mathbf{Q}}{\sqrt{d_{k}}} \right) $$
一方、実際の実装では$-\infty$の代わりに$-10^{9}$程度の非常に大きな負の数を加えるのが普通である。