層正規化
定義1
ニューラルネットワークのある層の出力を$\mathbf{a} = \begin{bmatrix} a_{1} & \cdots & a_{H} \end{bmatrix}^{\mathsf{T}} \in \mathbb{R}^{H}$とする。$\mathbf{a}$の成分の平均$\mu$と標準偏差$\sigma$は次のとおりである。
$$ \mu := \frac{1}{H} \sum_{i=1}^{H} a_{i} , \qquad \sigma := \sqrt{ \frac{1}{H} \sum_{i=1}^{H} \left( a_{i} - \mu \right)^{2} } $$
ゲインgain$\mathbf{g} \in \mathbb{R}^{H}$とバイアスbias$\mathbf{b} \in \mathbb{R}^{H}$に対して、次のように定義される標準化関数$\operatorname{LN} : \mathbb{R}^{H} \to \mathbb{R}^{H}$を層正規化layer normalizationという。
$$ \operatorname{LN}(\mathbf{a}) := \mathbf{g} \odot \dfrac{ \mathbf{a} - \mu \mathbf{1} }{\sigma} + \mathbf{b} $$
ここで$\mathbf{1} \in \mathbb{R}^{H}$はすべての成分が$1$であるベクトルであり、$\odot$はアダマール積である。成分ごとに書くと$\left[ \operatorname{LN}(\mathbf{a}) \right]_{i} = \dfrac{g_{i}}{\sigma} \left( a_{i} - \mu \right) + b_{i}$である。
説明
$X$の平均と標準偏差による$Z = \dfrac{X - \mu}{\sigma}$のような変換は、統計学では標準化standardizationと呼ばれるものだが、機械学習の分野ではこれを正規化normalizationと呼ぶ。データに施すあらゆる変換を区別なく正規化と呼ぶ傾向が強い。
提案された論文ではゲインとバイアスを$\mathbf{g}$、$\mathbf{b}$と書くが、$\boldsymbol{\gamma}$、$\boldsymbol{\beta}$という表記もよく使われる。一方、実際の実装では$\sigma = 0$のときに$0$で割るのを防ぐため、分母に小さな$\epsilon > 0$を加えて次のように書く。
$$ \operatorname{LN}(\mathbf{a}) := \mathbf{g} \odot \dfrac{ \mathbf{a} - \mu \mathbf{1} }{\sqrt{\sigma^{2} + \epsilon}} + \mathbf{b} $$
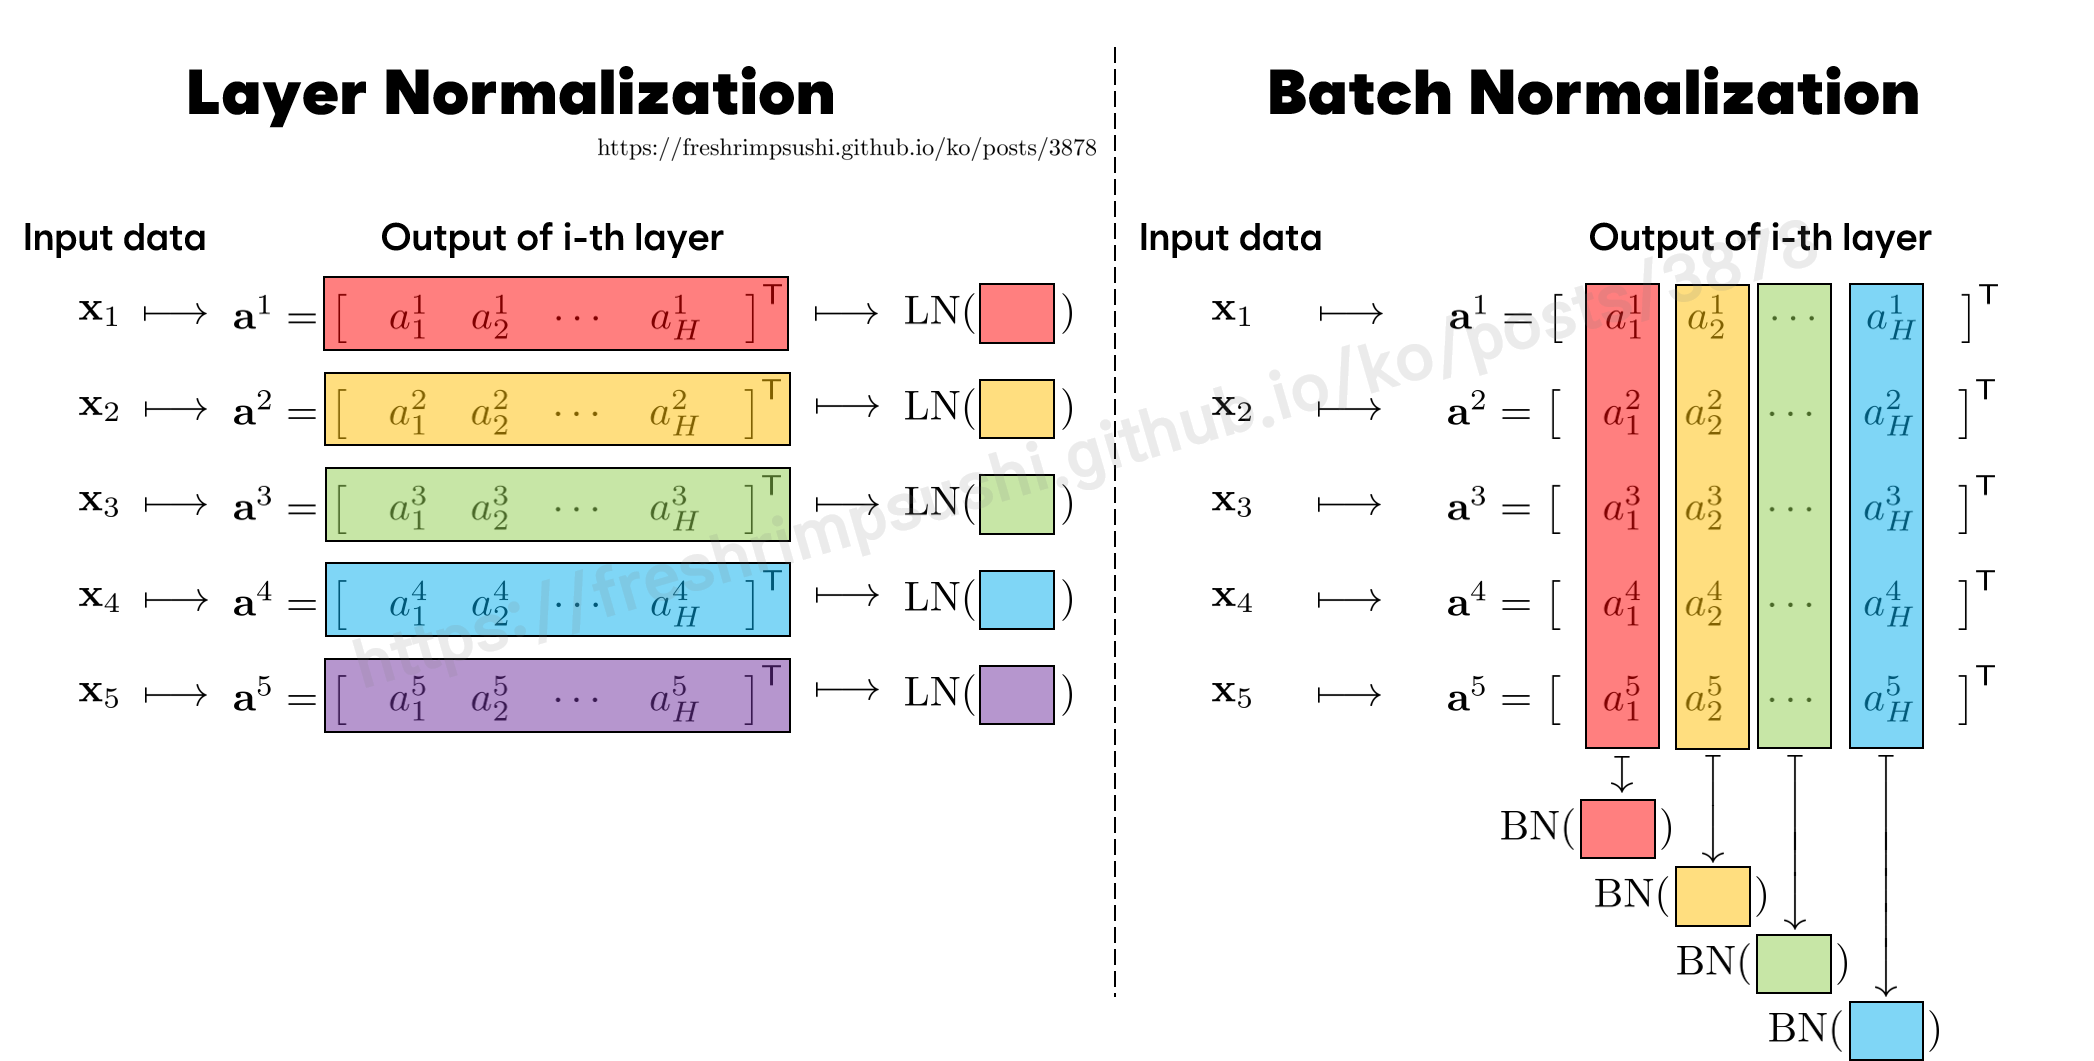
🔒(26/09/02)バッチ正規化は入力データを特定のバッチにまとめ、そのバッチごとに正規化するのに対し、層正規化は入力データ一つに対して正規化する。つまりバッチ正規化では同じ特徴についてミニバッチのすべてのデータが同じ$\mu$と$\sigma$を共有するが、層正規化ではデータごとに異なる$\mu$と$\sigma$を持つ。層正規化はデータごとに系列の長さが異なる再帰型ニューラルネットワークのように、バッチ方向に正規化しにくい場合にもそのまま適用でき、トランスフォーマーがバッチ正規化ではなく層正規化を使う理由もここにある。
バッチ正規化と比較してどのように動作するかを視覚的に表すと以下のとおりである。$\mathbf{a}^{k}$を$k$番目のデータに対する出力とする。
関連リンク
Jimmy Lei Ba, Jamie Ryan Kiros, and Geoffrey E. Hinton. Layer Normalization. arXiv preprint arXiv:1607.06450 (2016). https://arxiv.org/abs/1607.06450 ↩︎