時系列の複雑さを測る指標:順列エントロピー
定義1
時系列$\left\{ y_{t} \right\}_{t=1}^{T}$が与えられているとしよう。オーダーorder$n$個の連続する時点をまとめたベクトル$\left( y_{t+1}, \cdots , y_{t+n} \right)$を考えることにし、このようなベクトルは全部で$T - n + 1$個あるだろう。ベクトルの成分に大きさの順に$1$から$n$までの整数を割り当てたランキングrankingのベクトル$\pi$は、順列として数えるとちょうど$n!$種類が存在しうる。$p (\pi)$は次のように、ベクトルが$\pi$の型に属する比率として定義される。 $$ p (\pi) := \frac{ \left| \left\{ t : \left( y_{t+1}, \cdots , y_{t+n} \right) \text{ is of type } \pi \right\} \right| }{T - n + 1} $$ ここで$\left| \cdot \right|$は集合の基数である。$n$に対する順列エントロピーpermutation entropy$H(n)$は次のように定義される。 $$ H (n) := - \sum_{\pi} p (\pi) \log p (\pi) $$
説明
実のところ、定義における$\pi$が何なのかさえきちんと把握できれば、エントロピーの定義そのものはシャノンエントロピーと同一なので、まったく難しくない。順列エントロピーは、時系列が最も単純な場合、たとえば増加するだけか減少するだけのときには$0$になり、無作為性の強いカオスやブラウン運動などでは大きな値を取るだろう。
一方で、$0 \le H(n) \le \log n!$とはいえ、複雑さとは無関係に$n$が大きくなるほど$H(n)$が増加することもある。そのため概念的には$H$で十分だが、通常はシンボルあたりの順列エントロピーpermutation entropy per symbol$h_{n}$を次のように定義して用いる。 $$ h_{n} := \frac{H(n)}{n-1} $$
次はロジスティック写像において分岐パラメータ$r \in [3.5, 4]$を変えながら描いた分岐図と、それに対応するリアプノフ指数$\lambda$、そして$h_{6}$と$h_{12}$を比較したものである。
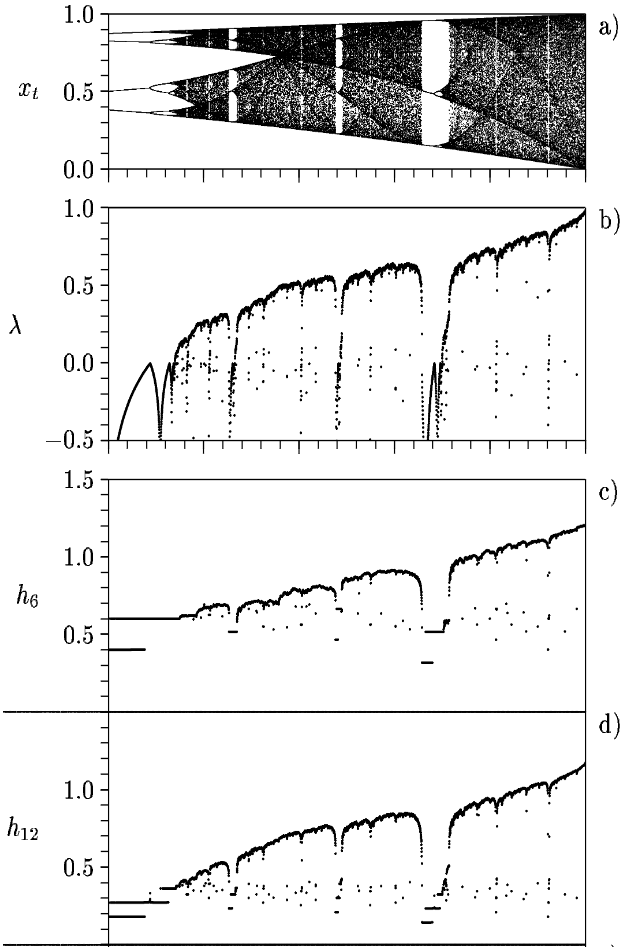
$h_{6}$と$h_{12}$は$\lambda$とほぼ似た形を示しつつ、$h_{12}$のほうがより似ていることが確認できる。リアプノフ指数と順列エントロピーの概念や定義がまるで異なることを考えれば、これほど似ているのも驚くべきことである。
もちろん、$\lambda$は$0$より大きいか小さいかの比較によってカオティックであることを明確に示してくれるのに対し、$h_{n}$はその基準点が明瞭でないという違いはあるものの、短い線分によって周期的な区間がどこにあるかを推測する程度のことはできる。
Bandt, C., & Pompe, B. (2002). Permutation entropy: a natural complexity measure for time series. Physical review letters, 88(17), 174102. https://doi.org/10.1103/PhysRevLett.88.174102 http://materias.df.uba.ar/dnla2019c1/files/2019/03/permutation_entropy.pdf ↩︎